網格解析度
MachiningResolution_mm (API) 是構成工件的那些立方體的邊長,也是決定一次仿真要跑多久的最大單一槓桿。它同時是最常被設定一次就再也沒人動過的設定,而這在兩個方向上都很昂貴:太細,本該幾分鐘跑完的運行會跑上幾小時;太粗,程式本該切到的特徵根本不存在、無從切起。
選擇數值
選擇之前,先由程式與工件估算記憶體。表面大而複雜、程式又短的工件——例如輪形件——網格幾乎就是全部,寬度決定這次運行放不放得進;長程式時,每步結果是任何寬度都降不下來的下限,而寬度必須放進機器扣掉它之後剩下的空間。實際使用時,加工解析度從 2 mm(非常大的工件配大量程式的快速總覽)到 0.03125 mm(殼件上的精細切削)——記憶體規劃有估算方法,以及哪種情境用哪一階。
先用粗的。早期的運行回答的是一些不需要細網格的問題 —— 路徑會不會碰撞、力是否大致落在該有的位置、優化器有沒有餘裕 —— 而且只花一小部分的時間就能回答。只在最後的優化那一趟才細化,因為那一趟產出的幾何才是交付物。
作為規劃用的概數,一次仿真運行大約需要實際加工時間的 2% 到 150%,依網格與步數的不同而跨越整個範圍。範圍這麼寬,是因為它真的是一種選擇,而不是機器的固有性質。
時間實際花在哪裡、兩個成本中目前哪一個是瓶頸,寫在仿真 CPU 使用率裡。簡短版:在真實 NC 加工所需的細解析度下,幾何移除主導,網格越細就慢得多;一旦網格粗到移除已經很便宜,每步成本便成為主導,再變粗也買不到任何東西。
你實際得到的值
你打進去的數字是一個請求,不是實際的寬度。工件是從一個立方體網格裡雕出來的,這個網格從一個固定的根立方體開始、逐層對半分割,所以引擎實際能建出的每一種寬度都是以毫米計的 2 的次方:
... 2 - 1 - 0.5 - 0.25 - 0.125 - 0.0625 - 0.03125 ...
不在其中的請求會被取整到下一個更細的值,絕不會取到更粗的值,所以你得到的網格絕不會比你要求的差。值得知道的後果是,選一個不在階梯上的值什麼也買不到:
| 請求值 | 實際建出 |
|---|---|
| 0.5 | 0.5 |
| 0.4 | 0.25 |
| 0.3 | 0.25 |
| 0.25 | 0.25 |
| 0.2 | 0.125 |
| 0.125 | 0.125 |
0.4 mm 與 0.25 mm 產生相同的網格、付出相同的代價。 0.4 就是貼了誤導標籤的 0.25:讀起來像是粗而便宜的設定,跑起來卻是細而昂貴的。如果 0.25 mm 比這次運行所需的還細,下一個真正會改變什麼的值是 0.5 mm —— 往另一個方向走,0.125 mm 則是體素數再乘以八,不是一小步。
階梯的底端是 0.001953125 mm。更細的請求會被夾限到這個值,所以工件的初始解析度 (Initial Resolution) 清單裡提供的最細那一項,建出的網格與它上面那一項相同。
寬度只會變得更細
已經存在的網格無法被變粗。每一刀切削都取已建好的寬度與正被請求的寬度之中較細的那一個,所以把加工解析度 (Machining Resolution) 調高到工件建構時的網格之上並不會簡化任何東西 —— 這個請求會被丟棄,運行繼續用它已有的網格。
這就是為什麼這兩個設定不能互換。工件的初始解析度 (Initial Resolution) 建構毛胚的網格,因此決定程式還沒碰到的每一個表面的記憶體;加工解析度 (Machining Resolution) 則限制新切出的表面可以細到什麼程度,而且只能往細的方向走。要讓毛胚在記憶體上更便宜,請把初始解析度調粗 —— 只把加工解析度調粗,對已經在那裡的毛胚什麼也改變不了,不過它確實會讓程式切出來的部分維持較粗。
它也會改變時間,而且改變很多,因為同一個數字還決定了另外兩件事的大小:在每轉進給與每刃進給下,刀具本身實體的三角化 (tessellation)(在固定步進下,三角化由固定步進自己的線性解析度與旋轉解析度決定:一步移除什麼),以及每步的接觸層數量。兩者都是每步用完就丟掉的工作,所以即使尖峰記憶體幾乎不動,較粗的加工解析度也能把運行時間縮短好幾倍。在一次記憶體主要是每步結果的運行上實測,從 0.25 改成 0.5 mm,時間少了 43%、尖峰少不到 3%,而粗加工後記錄下來的網格小了 3.6 倍。一次變快了卻沒有變小的運行,就是這麼回事,不是什麼謎;切出來的表面很大時,較小的網格也會反映在尖峰上。
從階梯上挑值,任務 (mission) 列裡顯示的數字就是運行實際用的數字。這不只是整潔的問題:第 0 階段的記錄是以工件的初始解析度 (Initial Resolution) 快取毛胚 —— 而不是以記錄所在之處當時生效的加工解析度 (Machining Resolution) —— 所以一個不在階梯上的初始解析度,會被悄悄地以它取整後的鄰值烘進快取裡。
授權允許什麼
Sentinel 授權鎖不帶下面任何一種上限;雲端帳號的授權可能帶其中之一或兩者,而 「說明」›「授權…」 會顯示生效中的上限——見用雲端帳號登入。
授權可以相對於工件來限制寬度:素材的建立與切削的進行,都不得比工件最長邊的某個固定比例更細——這裡的最長邊,是建出素材的那個形狀其邊界框的最長邊;由多個子幾何組成的 GeomCombination,則是整個組合的邊界框的最長邊,和它的子幾何合成一個網格時一樣——雖然素材是先由其中最大的那個子幾何建出,其餘的子幾何再以聯集併入。這個商數往粗取到階梯上的一級,絕不往細取:算出來是 2.9 mm 就允許 4 mm,正好是 2 mm 就允許 2 mm。兩個選擇器——工件的初始解析度與加工解析度命令——都把上限顯示出來,而不是藏起來:比授權寬度更細的各級反灰,並附一行提示寫出那個寬度、那個比例與最長邊。已經比它更細的值仍然選得到,第二行提示則說運行實際改做什麼:素材以授權的寬度建立,建構時帶著警告 Workpiece-InitResolution--ClampedByLicense;切削也以它進行,運行的第一步帶著 MachiningResolution--ClampedByLicense,每次重置一則。
這個上限限制的是加工,不是檔案。不論授權怎麼說,.wct 都以它自己的解析度讀入。比授權寬度粗的,接下來就和任何素材一樣,切削不會比那個寬度更細;已經比它細的,切削則不會比它自己的寬度更細——這時起作用的限制,是上面「寬度只會變得更細」那條規則。不論哪一種,比授權與素材兩者都更細的加工解析度,都會被夾限到這兩個寬度之中較細的那一個、附上警告;比授權細、卻不比素材細的請求,什麼也不會細化,也不會有警告。選擇器說的是同一件事:比切削實際進行的寬度更細的各級反灰,而素材已經比授權更細時,另有一行提示這麼說。
從未選定的值會跟著授權走,而不是被夾限。從新增命令對話框直接新增在任務根節點正下方的加工解析度命令,起始值是 0.125 mm 與授權對目前工件所允許的寬度兩者之中較粗的那一個(新增進巢狀清單的,和產生副本一樣從 0.125 mm 開始);而對設置的一次編輯——挑選、更換或移動毛胚幾何,以及其他幾種——會讓仍停在單純 0.125 mm 預設值的初始解析度,連同任務根節點正下方仍停在那個值(或停在這條規則先前自己寫入的值)的各個加工解析度命令,跟上同一個授權預設值——工件變大就往上、變小就再往下——各附一則訊息(Workpiece-InitResolution--DefaultFollowsLicense、MachiningResolution--DefaultFollowsLicense),所以專案存下的數字就是運行建出的數字。明確設定的值,包括 0.125 mm 在內,在專案開著的期間是使用者的:它會被保留,並在它被使用之處被夾限、附上警告;而載入專案不改變任何東西,所以存得比授權更細的專案會在夾限之下運行、帶著那些警告,直到它的值被設定——或者,對仍停在單純預設值的那些而言,直到下一次對設置的編輯讓它們跟上為止。重新開啟之後,0.125 mm 不論是誰設的,都再次讀作單純的預設值,並在下一次對設置的編輯時跟上——要保留它,就再設定一次,或改設另一級。
授權也可以限制自執行環境上次重置以來的加工步數。到達上限時,播放器會停在它拒絕的那一步,該步的診斷裡帶著錯誤 MachiningStep--LicenseCapReached,而且什麼也不會丟失:重置從零重新計數,繼續則再次要求同一步,所以期間若上限已被解除,運行就不留空隙地接著走——見開始與逐步執行。由你自己的程式碼、而非播放器驅動的播放,沒有東西能讓它暫停,改為在被拒絕的那一步結束。沒有上限時,什麼也不會改變。
它在記憶體上的代價
在小毛胚上,遠少於它在時間上的代價,這與階梯上四級 —— 細十六倍,因此體素是四千倍 —— 讓多數人預期的正好相反。在大工件上則正好倒過來(見下文)。量測方式是在程式與步數固定不變的條件下,把同一個案例掃過五級 —— 圓柱毛胚、一支粗加工程式、每次運行都是 199,242 步:
| 網格寬度 | 播放時間 | 受控堆積 (managed heap) 之外的程序記憶體 |
|---|---|---|
| 2 mm | 10.5 s | 665 MB |
| 1 mm | 15.3 s | 688 MB |
| 0.5 mm | 31.2 s | 722 MB |
| 0.25 mm | 76.6 s | 826 MB |
| 0.125 mm | 242.9 s | 1,456 MB |
細十六倍的代價是 23 倍的時間與 2.2 倍的記憶體。有兩件事把記憶體那一欄壓平了,值得把它們分開來看:
- 這個數字大部分是網格並不決定的基線。 掃描裡最粗的那次運行就已經佔了 665 MB,整個十六倍的細化只在它之上加了 791 MB。把這一欄當成增量而不是總量來讀:表格底部的比值,被數字裡那些在任何網格寬度下都會存在的部分稀釋了。
- 增量在粗寬度時成長緩慢,然後加速。 寬度每減半,依序增加了 23 MB、34、104、630 —— 每一個增量約為前一個的 1.5 倍、3.1 倍、6.1 倍,局部指數從約 0.6 爬到 2.6。一個立方體只要其內部的表面是單一平面小面 (facet) 就停止細分,所以在網格仍比零件的小面與曲率還粗的時候,細化大多什麼也買不到。體積縮放的直覺並沒有錯;它只是要等寬度低於特徵尺度之後才會到來,而一旦到來就來得很快。
在大工件上比例倒過來,寬度成了記憶體的設定。 當毛胚是一個大型匯入實體而不是小的程序式毛胚時,要細分的表面多得多,隨網格而變的那部分從粗的幾階就開始主導。一個 586 × 586 × 92 mm 的自由曲面殼件,以它本身匯入為毛胚、配一支 4.8 KB 的程式播放:從 1 mm 到 0.25 mm,運行只多花 7% 的時間,受控堆積以外的程序記憶體卻從 2.0 GB 增加到 3.2 GB;光是毛胚的網格,在 0.25 mm 是 3.2 GB、0.125 mm 是 7.1 GB、0.0625 mm 是 17.6 GB。程式這麼短,數字裡幾乎沒有別的東西,所以寬度決定這次運行放不放得進。記憶體規劃把這兩種運行並排比較。
不要用程序的峰值記憶體來判斷網格。 在一次長時間的運行裡,那個數字大部分是運行累積下來的每步資料,它們住在受控堆積上,隨步數而非網格縮放 —— 而且當網格細化時它往另一個方向走,因為較慢的運行配置記憶體的速度也較慢,垃圾收集器提交 (commit) 的也較少。兩者互相抵消:在一個較大的案例上量測四倍的細化,峰值記憶體略降,而網格本身的佔用量卻增加了近 40%。先把兩者分開來讀,再下任何結論。
網格不會改變的東西
以一個代表性的測試案例 —— 寬度與深度不一的向下圓形槽銑 —— 來說,物理量在整個網格寬度範圍內的變動約在 20% 以內。因此粗網格第一趟仿真出來的力、扭矩與溫度就已經有參考價值;網格細化後它們不會變成另一個答案。
看得見的幾何則是另一回事,下面三次運行顯示的正是這一點。工件 70 × 50 × 50 mm:
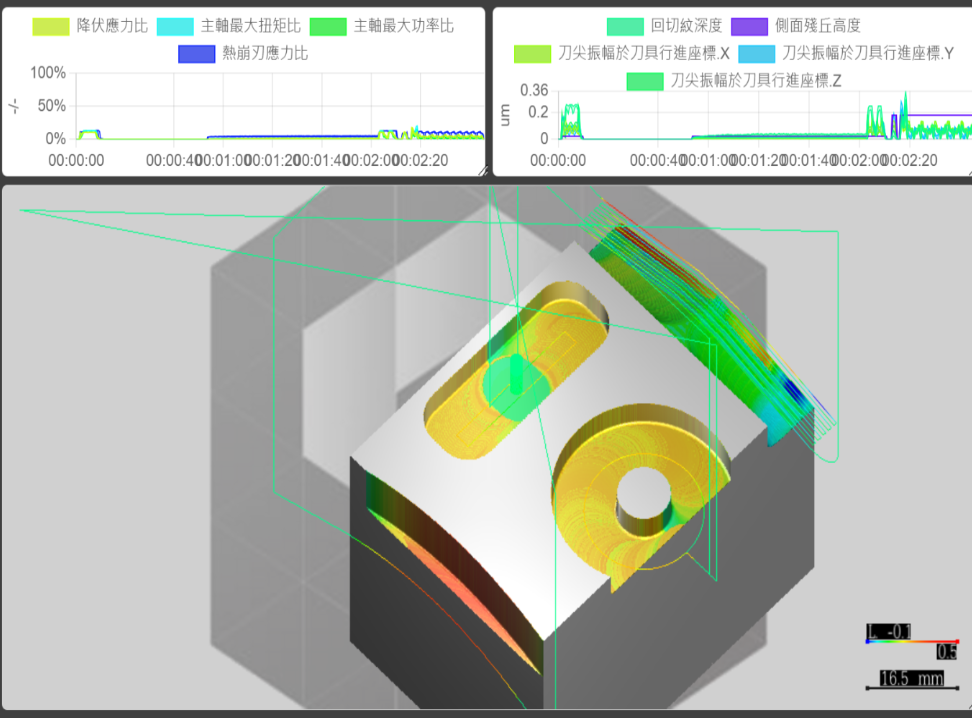 網格寬度 0.125 mm
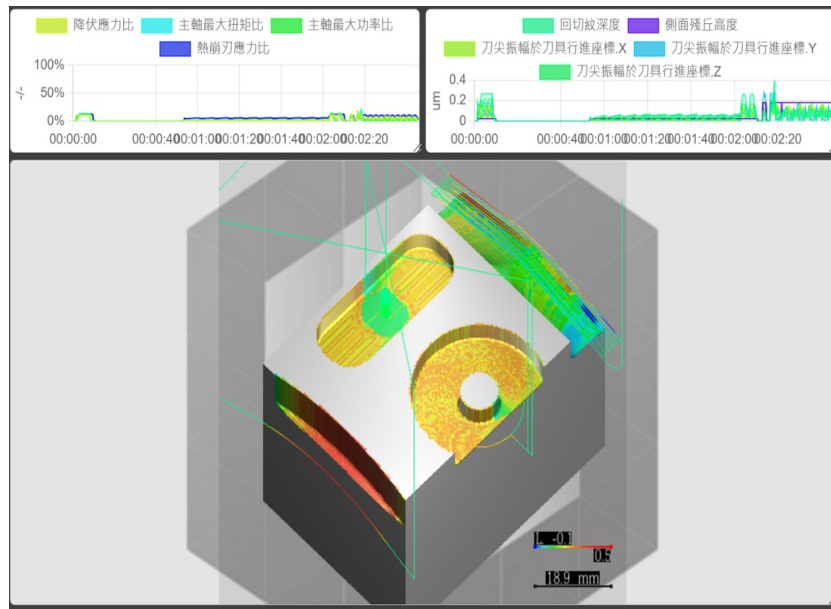 網格寬度 0.5 mm
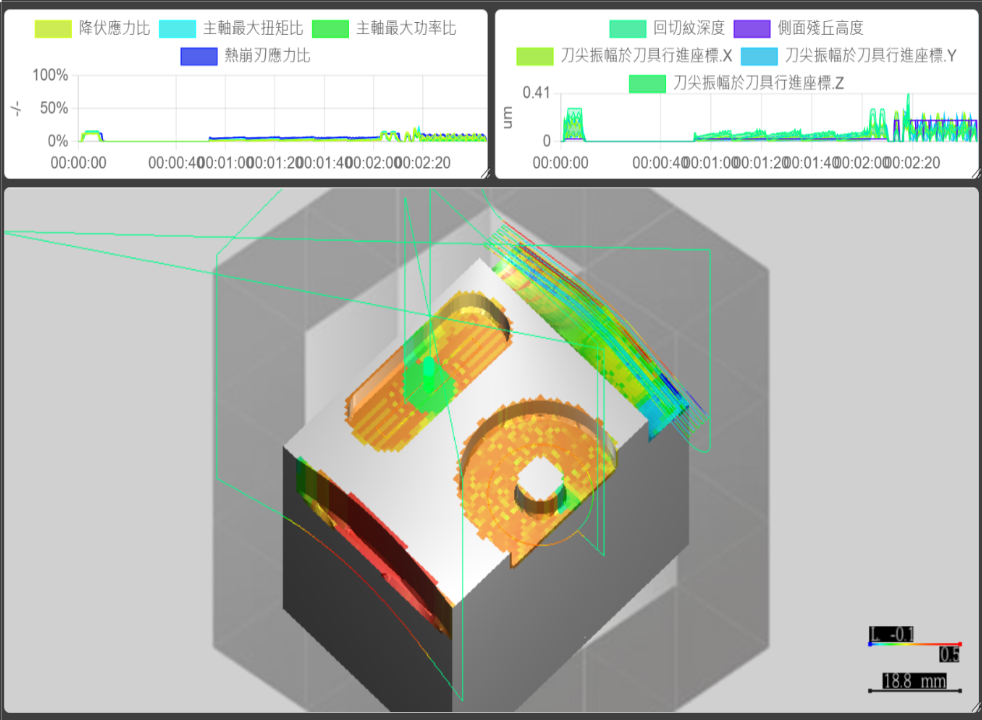 網格寬度 1 mm
切出來的形狀本身也落在網格上。一個面平行於網格、又貼近一排立方體角點時,刀具路徑只要差了遠小於一個立方體的量,承載這個面的那一排立方體就可能換掉:面仍留在切削把它放的位置,但在銳邊處把它封起來的那些小面 (facet),最多可能變動約一個立方體。幾何差異在每一格只塗一個值(網格在切削與幾何差異裡留下什麼)。
值得知道的失效模式
比網格寬度還薄的薄殼可能整個消失。 上面的測試案例沒有薄殼,這正是它的物理量如此不敏感的原因;有薄殼的零件行為就不同了,因為刀具本該遇到的材料根本沒有被表示出來。當工件有比網格寬度還薄的壁、腹板或底面時,網格必須比該特徵更細,運行才說得出關於它的任何事。
相關但小得多的效應是每步比值裡的量化漣波,較細的網格會減少它 —— 見製程可加工性。