仿真過程的 CPU 使用率
仿真的運算執行緒
時序資料的計算是單執行緒(同一時間只使用一個CPU核心),其他資料則可以平行計算。
幾何移除
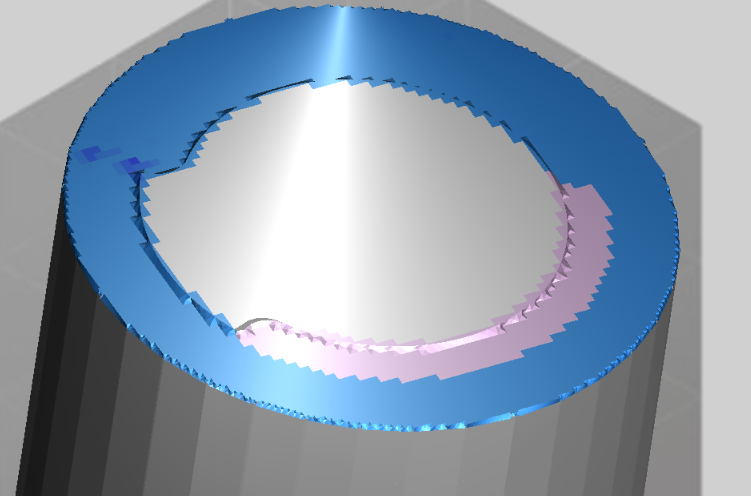
幾何移除是單執行緒,因為按照次序切削才能得到正確的CWE(刀具與工件嚙合)。幾何移除後的工件幾何表面是尚未著色的淡紫色,通常代表該處的物理量尚未計算完成。播放中途停止時,尾端那一段到下一次「重置」為止都是淡紫色:那些步永遠不會建出來。
物理計算
切削力的計算在取得CWE之後,因其不受計算次序影響,一般情況下為多執行緒計算。扭矩等物理量也會在這個階段平行計算。
溫度的計算必須是時序,所以又會收斂至單執行緒。
整個加工仿真的計算過程就這樣分分合合,一個步被計算完成後會在該步著上指定指標的顏色。
時間從哪裡來
總仿真時間來自網格、步數,以及開著時的碰撞檢測。網格與步數大致彼此獨立:
- 每步的工作(力、扭矩、功率、溫度、磨耗,以及
MachiningResolution_mm同時決定大小的刀具實體三角化與每步的接觸層)—— 每一步算一次。有多少步,由加工運動解析度連同刀具路徑上的主軸轉數決定,不取決於工件整體尺寸。一步本身的成本會隨網格寬度變,經由那個三角化與那些接觸層(網格解析度);這個變化在粗寬度比在細寬度小。把MachiningResolution_mm從 1.0 mm 提到 2.0 mm 仍然會縮短一次運行——同一組實測從 15.3 s 到 10.5 s——但縮短的幅度比那張表細的那一端小。 - 幾何移除(體素相減)—— 成本由網格解析度(
MachiningResolution_mm(API))決定。網格越細(數值越小)越貴,越粗(數值越大)越便宜。移除的工作侷限在刀具與工件的接觸區,因此大致與面積成正比,同樣與工件整體尺寸關係不大。 - 碰撞檢測 ——
EnableCollisionDetection開著時,每一步都做。網格粗、每步的工作本身已經便宜時,它可能是時間裡最大的一塊。不需要就關掉(幾何驗證)。
MachiningResolution_mm 確實控制移除解析度 —— 它不會被夾限掉、也不會被忽略。因為移除與每步的工作是並行的,較大的那一個才決定實際的牆鐘時間,碰撞檢測則加在兩者之上:
- 當幾何移除主導時 —— 在真實 NC 加工所需的細解析度下,這是常見情況 —— 網格越細就慢得多,網格變粗則能縮短總時間。
- 當網格已經粗到幾何移除很便宜時,改由每步的工作主導。此時再變粗 —— 例如把
MachiningResolution_mm從 1.0 mm 提到 2.0 mm —— 總時間仍會變,但比細網格時同一級的變化小(就是上面那組實測)。要加速,就用更粗的運動解析度來減少步數。(注意:對 NC 加工而言 1–2 mm 已經非常粗了。)
CPU的使用率
粗網格——物理計算為瓶頸
網格粗(MachiningResolution_mm 較大)的時候,幾何移除較物理計算快,所以仿真過程會看到一大片淡紫色跟在刀具後面跑。未計算完成的步數有數量限制,幾何移除在該數量內才會運行。所以在物理計算跟不上幾何移除的速度時,淡紫色的步數會維持固定數量。播放中途停止時,這些步到下一次「重置」為止都是淡紫色:它們永遠不會建出來。
這種情況主要是CPU的多核運算(物理計算),比較容易看到CPU多核使用率偏高。再把網格變粗,就不再省下幾何移除那一大段。它仍可能縮短運行,但少於細網格時同一級,因為網格寬度也決定每步工作的大小——見時間從哪裡來。要讓這一側跟著變短,就減少步數。
細網格——幾何移除為瓶頸
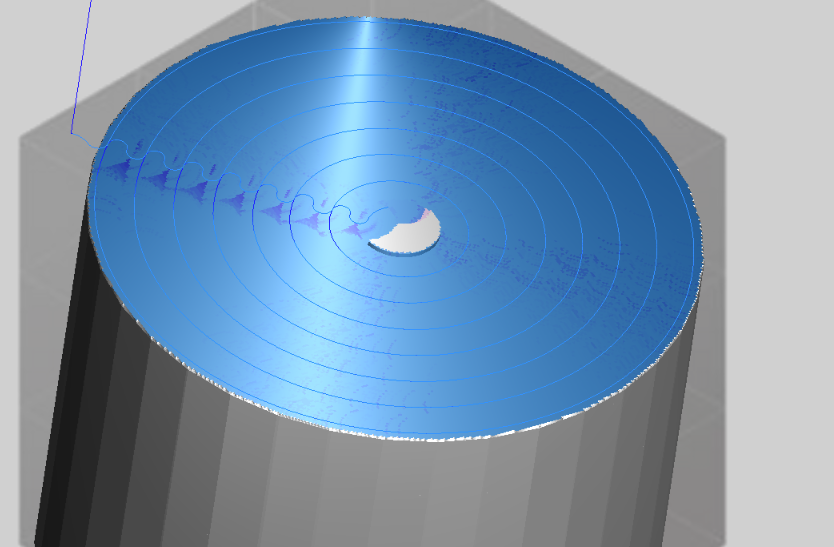
網格細(MachiningResolution_mm 較小)的時候,幾何移除較物理計算慢,所以幾乎看不到淡紫色。
這種情況主要是CPU的單核運算(幾何計算),把網格變粗就能縮短總時間。
平衡狀態
如果幾何解析度剛好使得幾何計算與物理計算不互相拖累,那淡紫色區域會出現,並在某個範圍內起伏。此時物理計算不會拖累幾何計算,通常幾何計算才是運算速度的瓶頸。
優化——一段爆發,然後只剩一核
NC 優化不是播放迴圈,它的 CPU 曲線是另一個形狀。它只有一個階段是平行的:逐步進給求解, 它把播放出來的步分散到一個私有的工作者池上、以低於一般的執行緒優先權跑,所以會讓在同一台機器上的 互動操作先行。它之後宣告的每一個階段——兩道進給約束、建立補正、重新產生 NC、寫檔——都是單執行緒的。
所以一趟優化會看到一段多核爆發,接著一條單核的尾巴。剩下的時間 CPU 維持在約一顆核心的負載上, 是預期的形狀,不是停住了。
宿主程式(host)的設定 HiNC:OptCoreNum 決定那唯一一個平行階段的規模。出貨值 0 表示每個邏輯處理器一個工作者;
設成其他值則以該數量為上限,把機器多留一些給別的工作、同時把那段爆發拉長。它只影響這一段:
不影響後面那些單執行緒階段,也不影響上面的仿真迴圈。
CPU未跑滿的情況
CPU沒有跑滿,原因可能包含:
- 作業系統為了確保GUI能即時反應,預留空間不讓跑。如Windows桌面軟體(如WPF)會把非GUI的執行緒優先權降一個等級。
- 軟硬體吞吐量對該程序已達極限。 回報的 CPU 使用率可能未達 100%,但快取、匯流排頻寬等其他資源可能已經飽和;分支預測失誤(Branch Misprediction)之類的系統層級因素也不會反映在回報的 CPU 使用率裡。
這兩項都沒有可調的設定。NC 優化時 CPU 看起來很閒是另一個問題,答案在上面那一節的階段形狀, 不在這份清單裡。
延伸閱讀
- 製程可加工性 — 較細的網格所消去的網格量化漣波,以及那在移除時間上的代價
- 主軸能力 (Spindle Capability) — 迴圈裡的另一個吞吐天花板:主軸能提供什麼,而不是工作站能算多快
- 網格解析度 — 挑選那個決定網格與步數哪一個才是阻礙的數值,以及這個選擇的實測時間
- 記憶體規劃 — 同樣兩個設定在記憶體上的那一面