Jetson AGX Thor 鋁機殼的 NC 優化:HiNC 讓三個裝夾少了 76 分鐘,看似已到極限的格柵也少了 37 %(3 軸)
- 原始來源
- Antmicro,Enclosure for Antmicro baseboard with NVIDIA Jetson AGX Thor,github.com/antmicro/jetson-agx-thor-baseboard-enclosure。
- 搜尋關鍵字
antmicro jetson-agx-thor-baseboard-enclosure、cnc-milled-bottom-shell-al- 授權
- Apache License 2.0,依原樣提供、不附任何保證。零件是 Antmicro 的模型,沒有改動;下方的畫面由 HiNC 依這些模型,加上代理的毛胚、夾具、刀具與程式繪出,圖表畫的是 HiNC 的逐步結果與優化器的逐步日誌。
- 標註
- Enclosure design (c) 2026 Antmicro, Apache-2.0, https://github.com/antmicro/jetson-agx-thor-baseboard-enclosure. Machining set-up by Tech Coordinate's agent (changes: stock, fixtures, toolpaths and their optimization).
機殼設計 (c) 2026 Antmicro,Apache-2.0;加工設定由超級高科技的代理完成,改動的是毛胚、夾具、刀路與刀路的優化。 - 關於這個案例
- Jetson AGX Thor 鋁機殼這個開源硬體鋁機殼通過驗收的三支程式:底殼與上蓋的第一次裝夾,用兩支 Ø12 mm 端銑刀粗加工與精修,主軸在它們的 8,000 min⁻¹ 給 11.8 kW;以及後面板的格柵,用一支 Ø1.5 mm 長頸刀花兩小時切 26 條槽。這裡由 HiNC 的進給優化接手這三支程式。
故事
機殼的驗收留下三個工廠會問的問題。兩支 Ø12 程式照代理保守的 CAM 規則——每刃 0.08 mm,每一次斜降進刀與每一層全寬的第一圈都用半速——精修時只要刀路吃到比留量更多的料,長刀就彎過案例的 25 µm 上限。格柵刀在案例的 0.25 mm 網格下,應力剛好頂在目標上,看起來進給已經沒有空間。一個 AI 代理把三支程式交給 HiNC 的進給優化——它依每一步讀到的負荷重寫每一行的進給——並問:粗加工的限制是主軸還是切屑?精修守得住 25 µm 嗎?格柵真的到極限了嗎?它先寫下標準、設定與決定規則,用每支程式的一小段、以及一條格柵槽的三種網格寬度試跑整條流程,在試跑證明計畫有錯的地方寫下修正,再把每支程式整支優化、重播:V1 讓每一行精修守住程式切屑,V2 再依量到的撓曲調整精修,V3 是格柵。這裡的每個數字都來自這些播放。
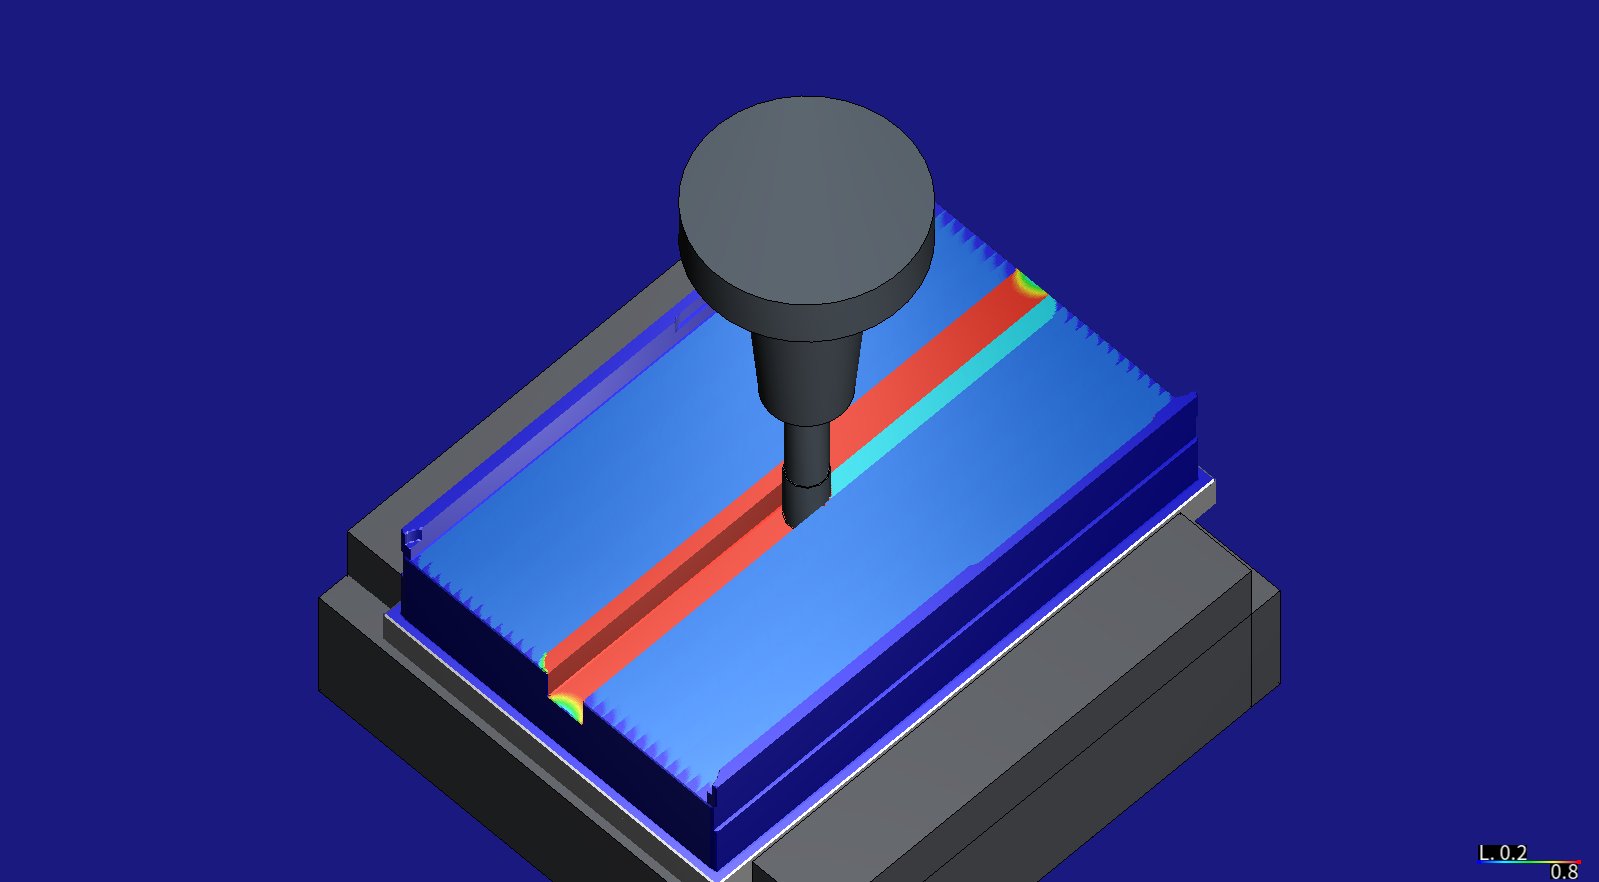
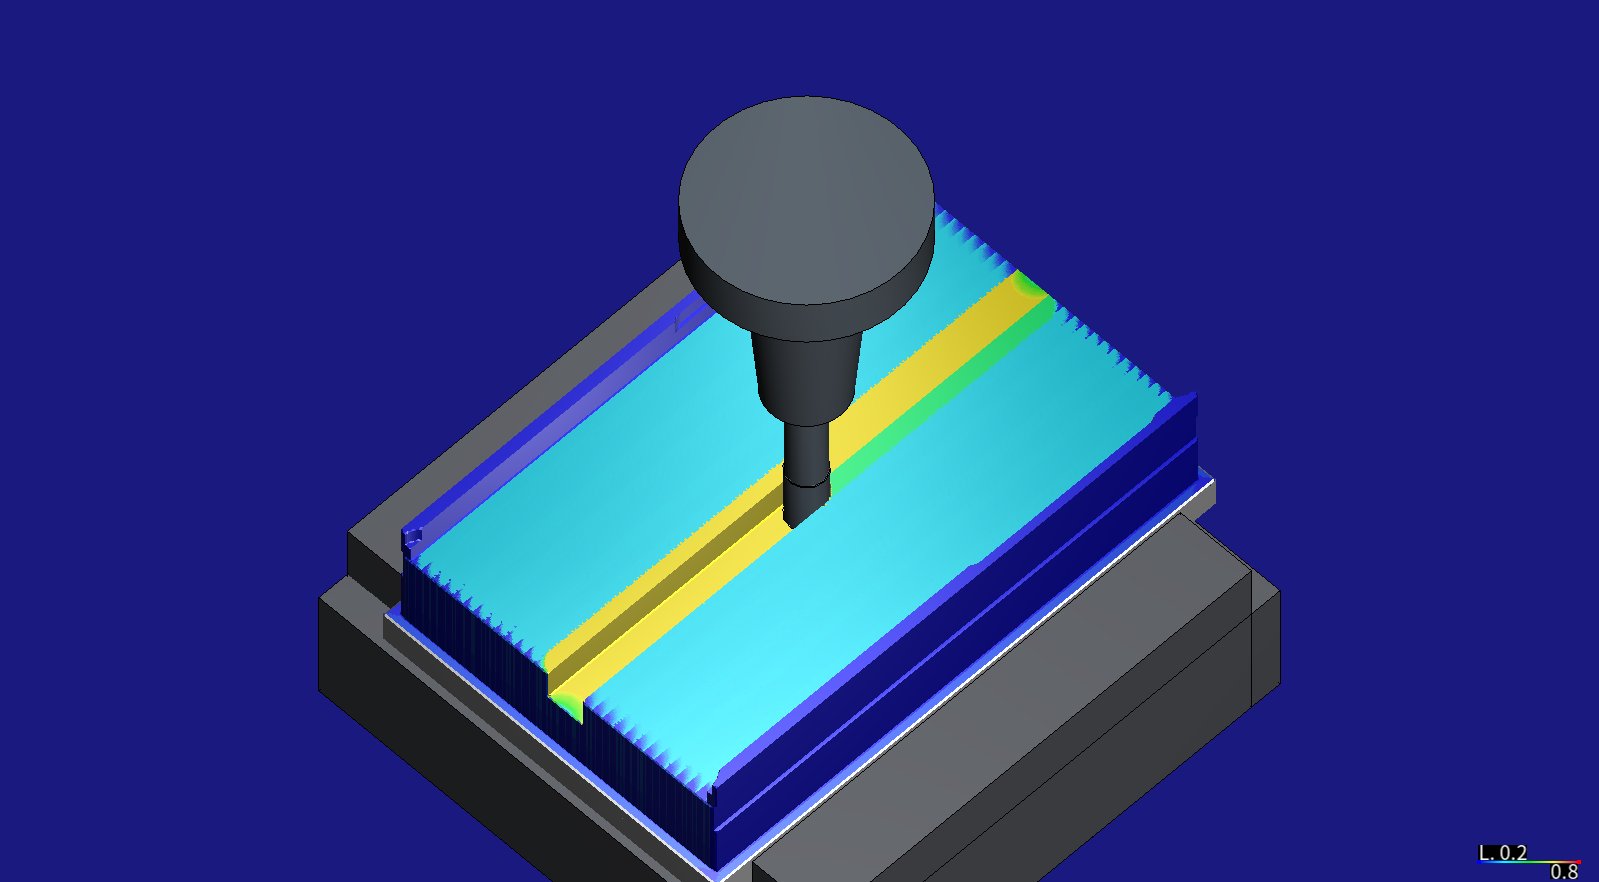
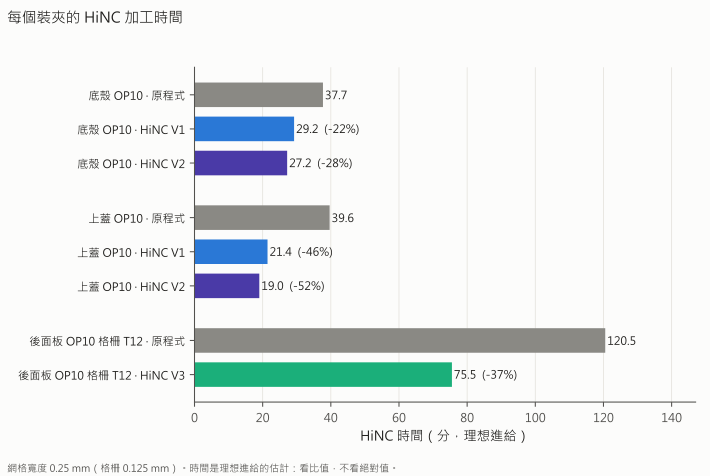
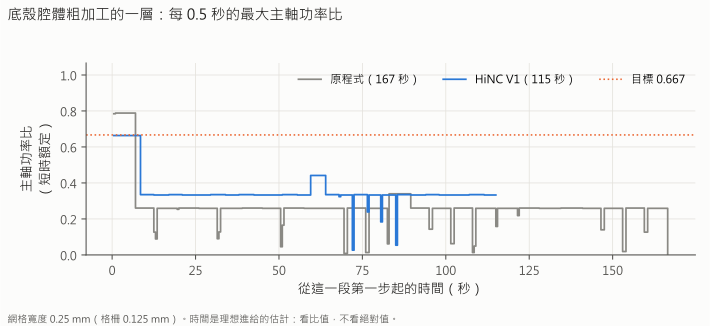
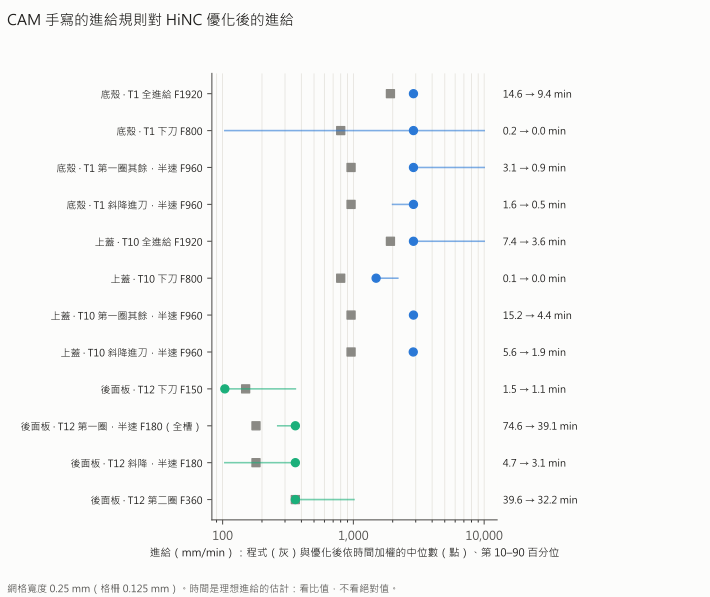
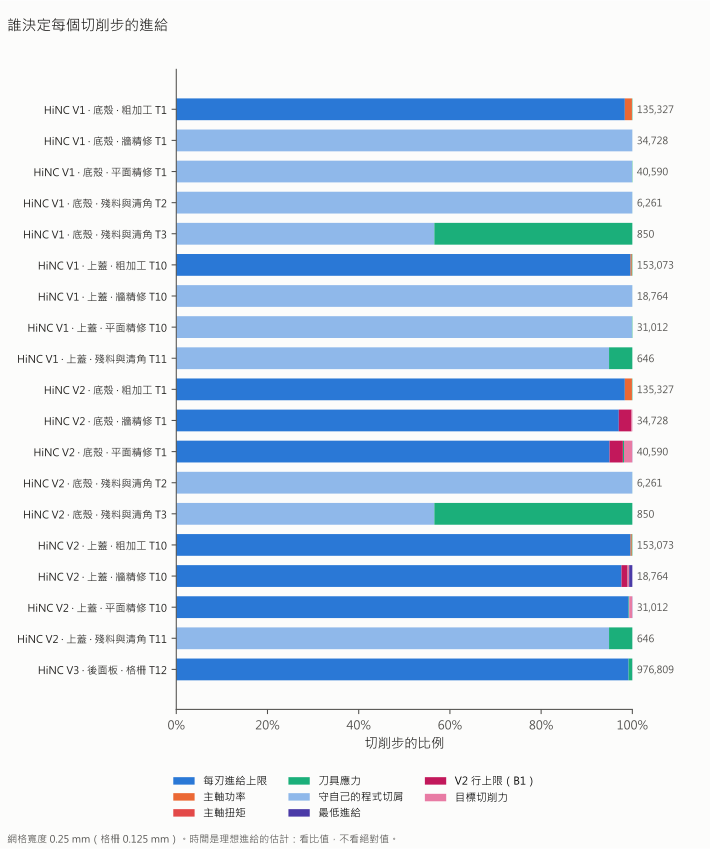
畫面由 HiNC 依 Antmicro 的模型(Apache-2.0)加上超級高科技的代理建的設置繪出。圖表畫的是 HiNC 的逐步結果與優化器的逐步日誌;時間是理想進給的估計,請比較比例,不要比絕對時間。
| 關鍵數字 | 代表什麼 |
|---|---|
| 37.7 → 27.2 分 | 底殼的第一次裝夾,V2(−27.9 %);精修照程式原樣的 V1 是 29.2 分(−22.5 %) |
| 39.6 → 19.0 分 | 上蓋的第一次裝夾,V2(−52.0 %);V1 是 21.4 分(−46.0 %) |
| 120.5 → 75.5 分 | 後面板的格柵段(−37.3 %) |
| 76.1 分 | 三支程式省下的時間,197.9 → 121.7 分:切削 60.5 分、空中進給 15.6 分 |
| 98.4/99.6 % | Ø12 粗加工的切削步跑到代理允許的每刃 0.12 mm 上限的比例:限制是切屑,不是主軸 |
| 0.788 → 0.664 | 底殼粗加工最大的主軸功率比,目標是短時額定的 0.667;超過目標的 2,076 步一步不剩 |
| 72 % | 上蓋粗加工花在 CAM 半速圈的時間,優化器讓它們用三倍的進給走 |
| 36.5 → 24.2 µm | 上蓋精修最大的撓曲(V2),對照案例的 25 µm;底殼 42.6 → 26.7 µm |
| 0.338 → 0.333 | 格柵刀最大的應力比,就在目標上,99.2 % 的步跑到程式切屑 |
| 1 µm、0.001 % | 形狀:代理自己的毛胚高度圖兩百萬個格點裡除了一個,都相差在 1 µm 內;HiNC 匯出的零件體積相差在 0.001 % 內 |
| 12.5 分、57 GiB | 一支 Ø12 程式一次優化播放的伺服器時間與記憶體峰值;它的重播不到 8 分、4 GiB |
二十個難題中的四個
一刀精修裡有兩種切屑
CAM 進入每一層精修時,先斜降進刀、第一圈用半速,再用全速把同一圈走一次。每段一個上限會把半速那一圈加倍——那一圈切的正是留量——試跑中上蓋的精修撓曲從 36.5 升到 43.6 µm。所以每一行精修都守住自己的程式切屑:負荷可以讓它變慢,什麼都不會讓它變快,精修就照程式原樣切。
跳過斜降的目標切削力
優化器沒有撓曲準則,所以代理用每支刀的柔度,把 25 µm 換成目標切削力。逐步比對後發現,超過目標的等高步 93 步裡它壓下 69 步,斜降上的 92 步一步也沒壓——而最大的撓曲正落在那裡。所以 V2 再替每一行精修定一個取自這一行自己撓曲的上限:底殼 7,392 行裡 7,195 行升向型錄的精修切屑,133 行被壓慢。上蓋守住了 25 µm,底殼只差 2 µm 以內。
只是看起來到底的格柵
在案例的 0.25 mm 網格下,HiNC 讀到 Ø1.5 刀的應力頂在目標上。用三種網格寬度播第一條槽,半速那幾圈的應力中位數處處相同,但 0.25 mm 的尾巴高了 26 到 42 %:那是網格的,不是切削的。代理照試跑前寫下的規則改用 0.125 mm,99 % 的步跑到程式切屑:同樣的目標下少了 37 % 的時間。
比預測還快
計畫預測上蓋是 −15 到 −30 %,結果是 −46 %。和 CAM 自己的規則一對照就明白了:上蓋粗加工有 72 % 跑在半速圈上——斜降與每一層全寬的第一圈——HiNC 讀到它們遠低於目標,就用三倍的進給走。一條「全寬就用半速」的通則,是這些程式裡單一最大的浪費。
另外十六個在完整紀錄裡,其中八個較小的列成一張表;包括:乾淨的重播裡出現幾百則腳本訊息,最後查明只是同一個無害的模式;一個以空切進給掠過 0.06 mm³ 薄料的移動,那片料比 HiNC 的網格還窄;下刀被讀成整個刀面;以及一次在和線上服務共用的伺服器上用到 57 GiB 的優化播放。
結果
每支優化後的程式都重播到最後一行,沒有碰撞、行程或快移切料的警報,留下的零件也一樣:代理自己的毛胚高度圖兩百萬個格點裡除了一個,都相差在 1 µm 內,HiNC 匯出的零件體積相差在 0.001 % 內。三支程式少了 76 分鐘。Ø12 粗加工跑在代理允許的切屑上限,也就是程式切屑的 1.5 倍;只有每一層開頭全寬的那一刀被壓慢——原程式在那裡已經超過主軸的目標。V1 的精修完全照程式原樣;V2 依它自己量到的撓曲調整,比 V1 快,上蓋守在 25 µm 內,底殼最差的一步是 26.7 µm。看似到底的格柵也讓出 37 %。一切都是模擬,沒有切過任何零件。
帶來了什麼
- 對加工工程師:不動刀路,三支程式少了 76 分鐘;主軸真實的功率曲線逐刀對照,指出決定粗加工速度的是切屑上限而不是主軸;CAM 的保守習慣要付多少時間有了量測;精修先被保護,再在撓曲上限內加快。
- 對老師或學生:粗的網格為什麼會自己造出一個極限,目標為什麼要在它作用的地方檢查——斜降不是等高的切削——以及逐步日誌怎麼說出每一步的進給由哪個準則決定。
- 對正在評估要不要讓代理搭配 HiNC 的人:三支程式,十次整支程式播放與 27 次小播放,約 105 分鐘的伺服器時間;標準與決定規則先寫定,計畫只用書面的修正改動,每一條沒過的標準都連同原因報出來。
看完整的案例紀錄:Jetson AGX Thor 鋁機殼的 NC 優化
零件、裝夾與這些程式是怎麼做出來的:Jetson AGX Thor 鋁機殼。